
株式会社QunaSysは、誤り耐性量子計算(FTQC)向け量子化学計算アルゴリズムについて、産総研の「ABCI-Q」に搭載された1,024基のNVIDIA Hopper GPUとNVIDIA cuQuantumを活用し、3億ゲートを超える量子回路のEnd-to-End検証に成功したと発表しました。qubitization型量子位相推定(QPE)の回路構築からコンパイル、実行、結果解析までを一貫して実施し、水素4原子モデル(H4)の基底状態計算で化学精度を満たす結果を確認しています。
研究の背景とEnd-to-End検証の目的
材料や触媒の性質を把握するためには、分子が最も安定した状態にあるときのエネルギー(基底状態エネルギー)の算出が不可欠とされています。計算中の誤りを訂正しながら動作するFTQCは、こうした分子エネルギーを高精度に求める計算手法としての応用が期待されています。分子エネルギーを導出するアプローチのひとつであるqubitization型QPEでは、分子の性質を表現した計算モデルを量子回路へ組み込み、量子位相推定によってエネルギー値を読み取ります。
将来のFTQC実機上で大規模アルゴリズムを正しく機能させるには、量子回路の一部だけでなく、計算の準備からコンパイル、実行、測定結果の解析に至る全処理が想定通り動作するかを古典コンピュータ上で先行検証する必要があります。しかし、qubitization型QPEは多数の補助量子ビットと膨大な演算回数を要するため、大規模な古典シミュレーションには大量のメモリと膨大な計算時間が必要となり、従来の検証規模には制約が存在していました。
 Mr.ガジェット
量子コンピュータ実機が完成する前に、古典スーパーコンピュータやGPUクラスタを用いてアルゴリズムの全工程を事前に試行しておくことが実用化準備の鍵となります。
 Ms.ガジェット
実機が登場する前に、計算準備から結果の解析まで一連の流れが正しく機能するか確認しておくプロセスは極めて重要ですね。
検証に用いられた技術構成と計算環境
今回の検証では、量子回路の構築からコンパイル、シミュレーション、測定結果の解析までの全工程に同社の量子ソフトウェア開発基盤「QURI SDK Enterprise」が採用されました。回路構築の段階では、分子の計算モデルの組み込み手法や初期状態の準備手法を工夫し、必要となる量子ビット数と演算回数の削減を図っています。
シミュレーションのバックエンドにはNVIDIA cuQuantumを使用し、産業技術総合研究所(産総研)の量子・古典融合計算基盤「ABCI-Q」に搭載されたNVIDIA Hopper GPU 1,024基上で分散処理を実施しました。量子状態を表すデータを多数のGPUへ分割配置することで単一GPUのメモリ制約を解消しつつ、ノード内高速通信の優先利用とGPU間転送データ量の抑制により、通信オーバーヘッドを低減させています。また、複数GPUによるシミュレーションソフトウェアには、戦略的イノベーション創造プログラム(SIP)のもとで産総研と共同開発した「quri-parts-cuquantum」が使われています。
Mr.ガジェット1基のGPUメモリに収まらない巨大な量子状態データを1,024基へ分散させ、ノード内高速通信を優先させて通信遅延を抑える工夫が採られています。
Ms.ガジェット産総研のABCI-Q基盤とNVIDIA Hopper GPU、そしてcuQuantumの連携によって大規模な並列計算が実現されている点が興味深いです。
水素4原子モデル(H4)における化学精度の達成
H4に対するQPEの検証では、量子回路の最適化によって初期構成の見積もりである99量子ビット・約17.8億ゲートから、28量子ビット・約3.19億ゲートへと規模が縮小されました。この最適化回路を1,024基のGPUで実行し、約1.5時間でシミュレーションおよび約100万回分の測定結果生成を完了しています。
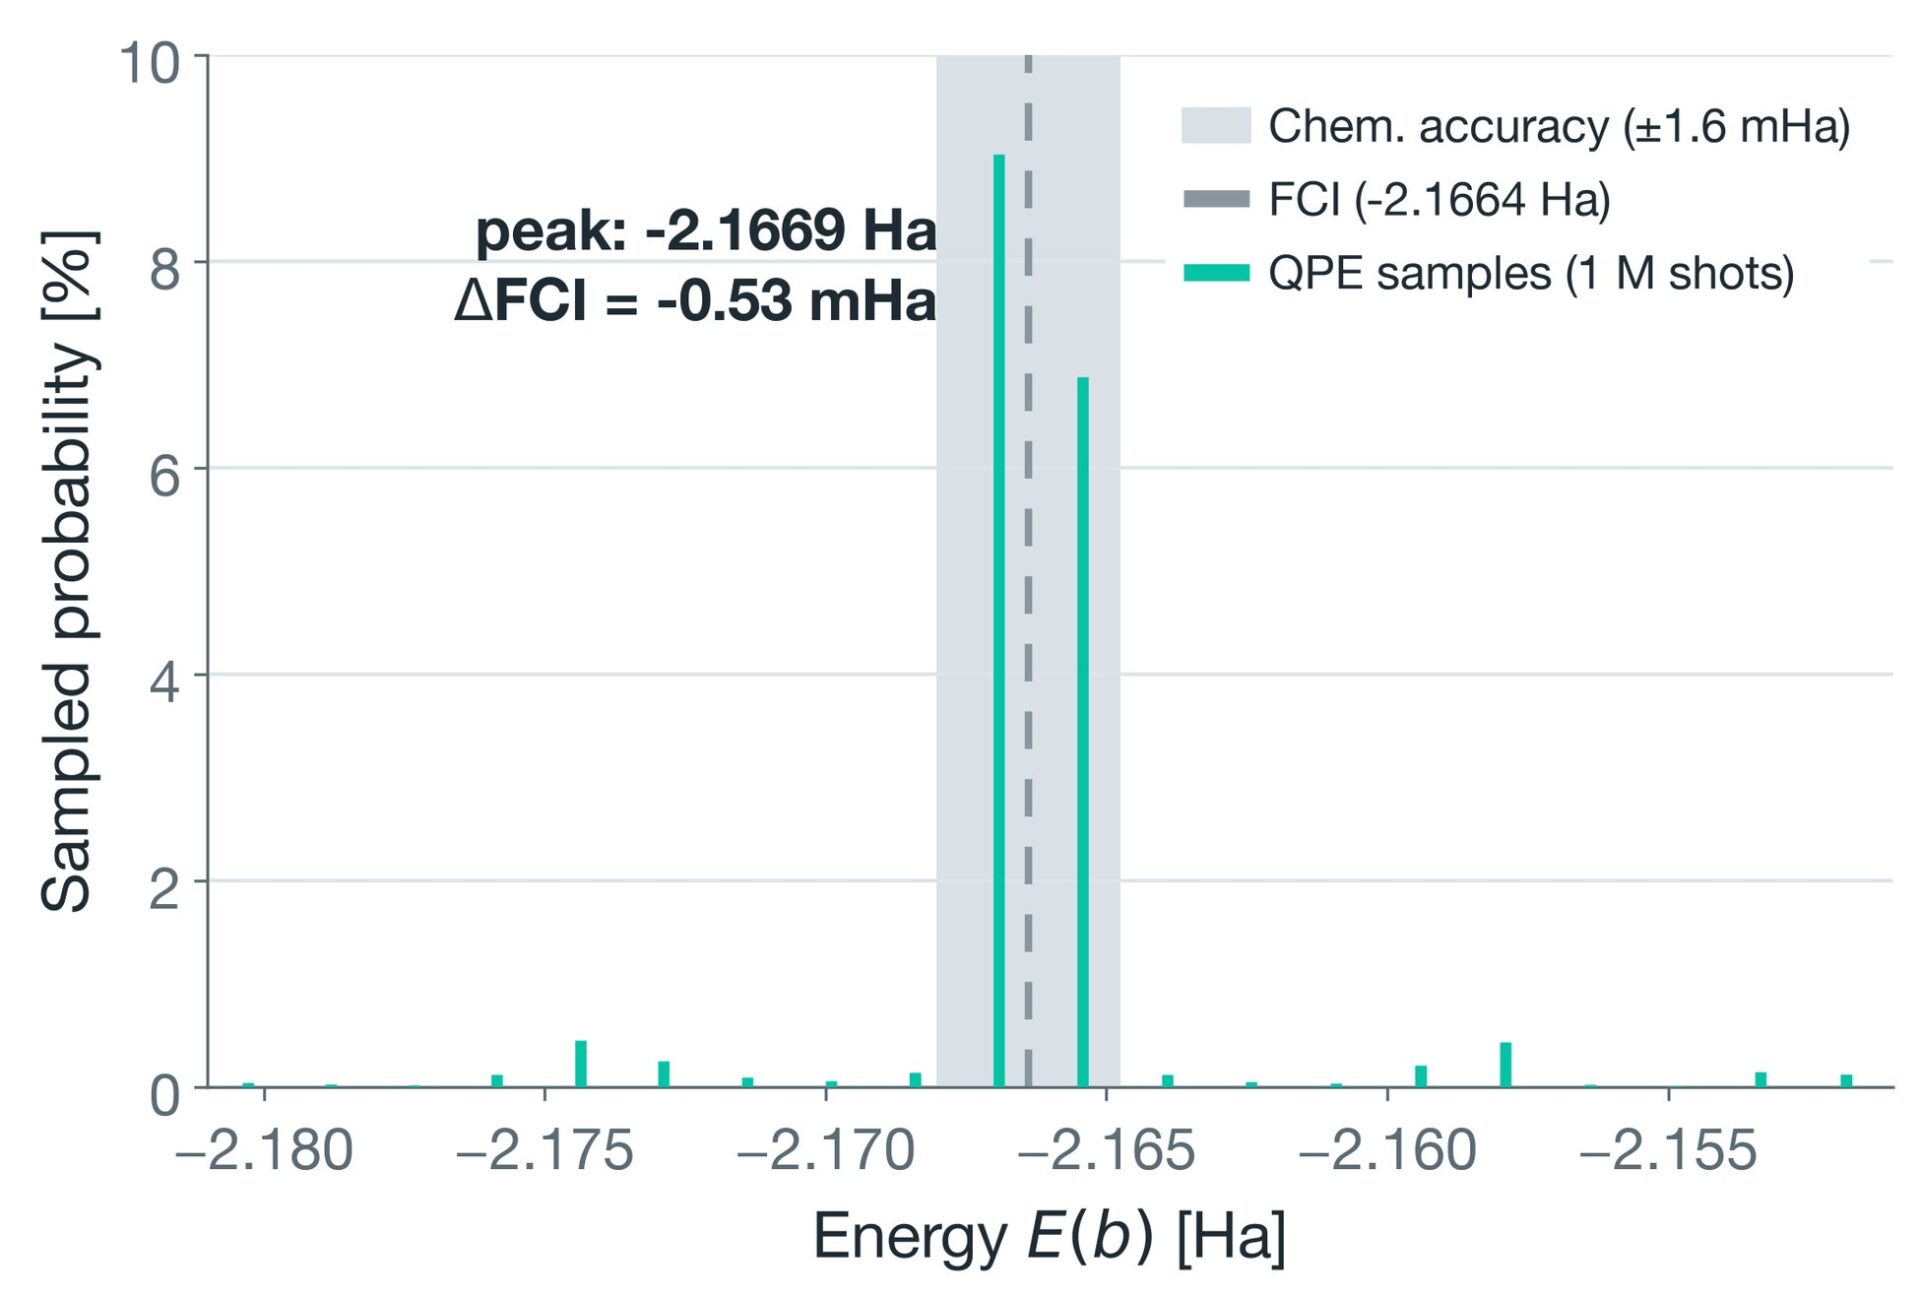
生成された約100万回分の測定分布を解析した結果、最も頻繁に観測されたエネルギー値と厳密解との差は0.53 mHaとなりました。これは量子化学計算の精度目標とされる「化学精度」(厳密解から±1.6 mHa以内)を満たす数値であり、単一の値だけでなく測定頻度分布を含めて想定精度の結果が得られることが確認されました。
Mr.ガジェット初期見積もりの約17.8億ゲートから約3.19億ゲートまで回路を最適化し、厳密解との誤差を基準の1.6 mHaを下回る0.53 mHaに抑えています。
Ms.ガジェット約1.5時間で約100万回もの測定データを出し切り、化学精度の基準をクリアしている点にアルゴリズム検証の精度の高さを感じます。
最大42量子ビットまでの回路規模拡大検証
古典シミュレーションで扱える回路規模の上限を探る検証として、許容誤差を緩和した条件での実験も行われました。水素原子を鎖状に並べたモデルをH2からH4、H6、H8、H10へと拡大し、最大規模となるH10において42量子ビット・約49万ゲートのQPE回路の実行を達成しています。
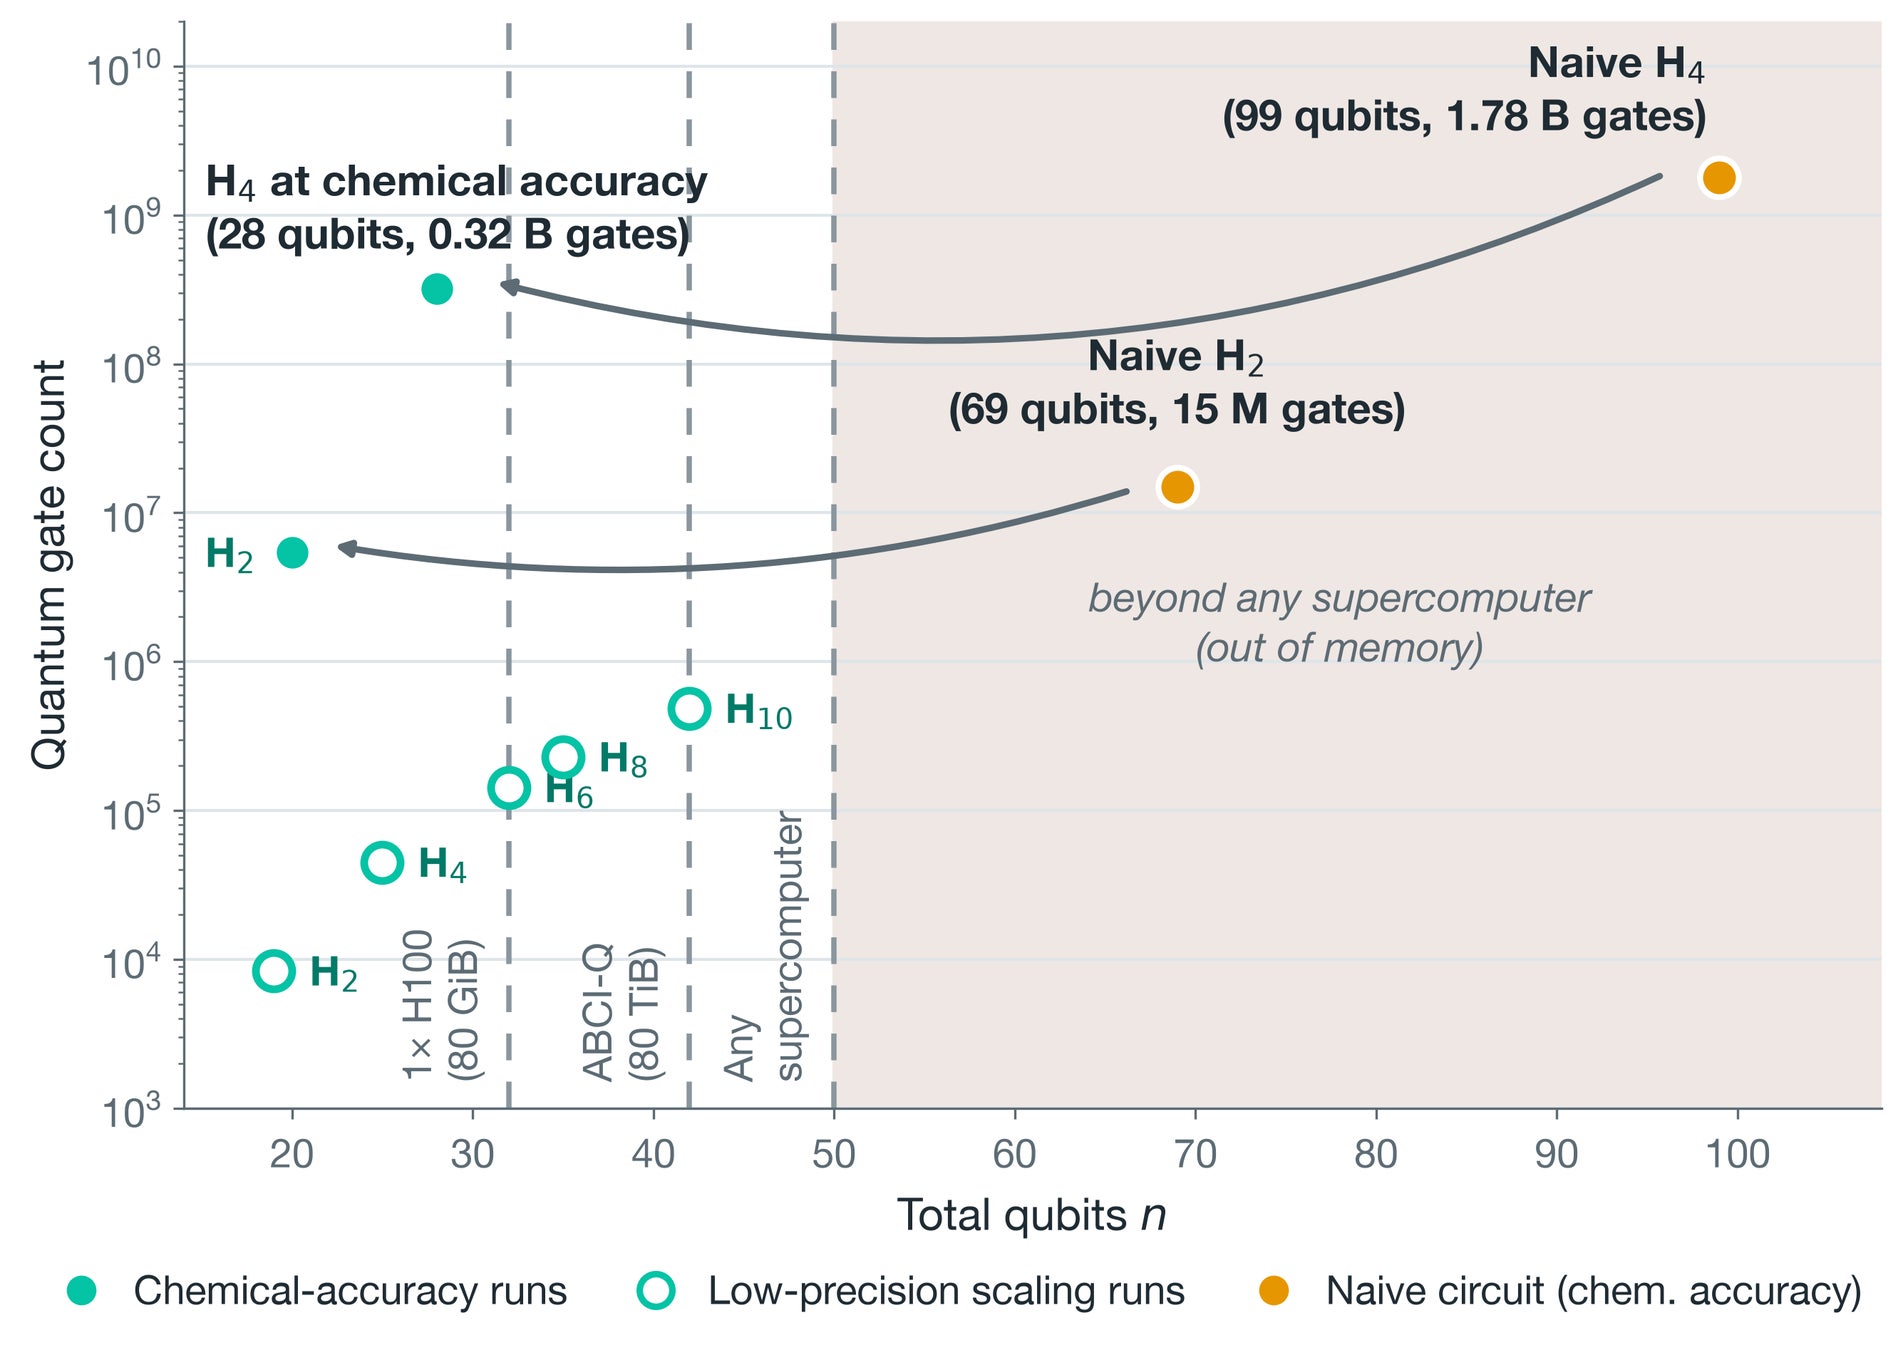
これにより、化学精度を追求して演算回数が膨大となる約3.19億ゲートの計算(H4)と、量子ビット数を42ビットまで拡張した計算(H10)の双方が実証され、ゲート数・量子ビット数それぞれの側面から処理能力が検証されました。
GPU並列処理による強スケーリング性能評価
計算内容を固定してGPU数を増加させた際の処理時間を測る「強スケーリング評価」では、H2に対する32量子ビットのQPE回路が用いられました。GPU 1基では約4,155秒を要していた処理が、512基の並列処理により約24秒へと短縮され、約173倍の高速化が測定されました。
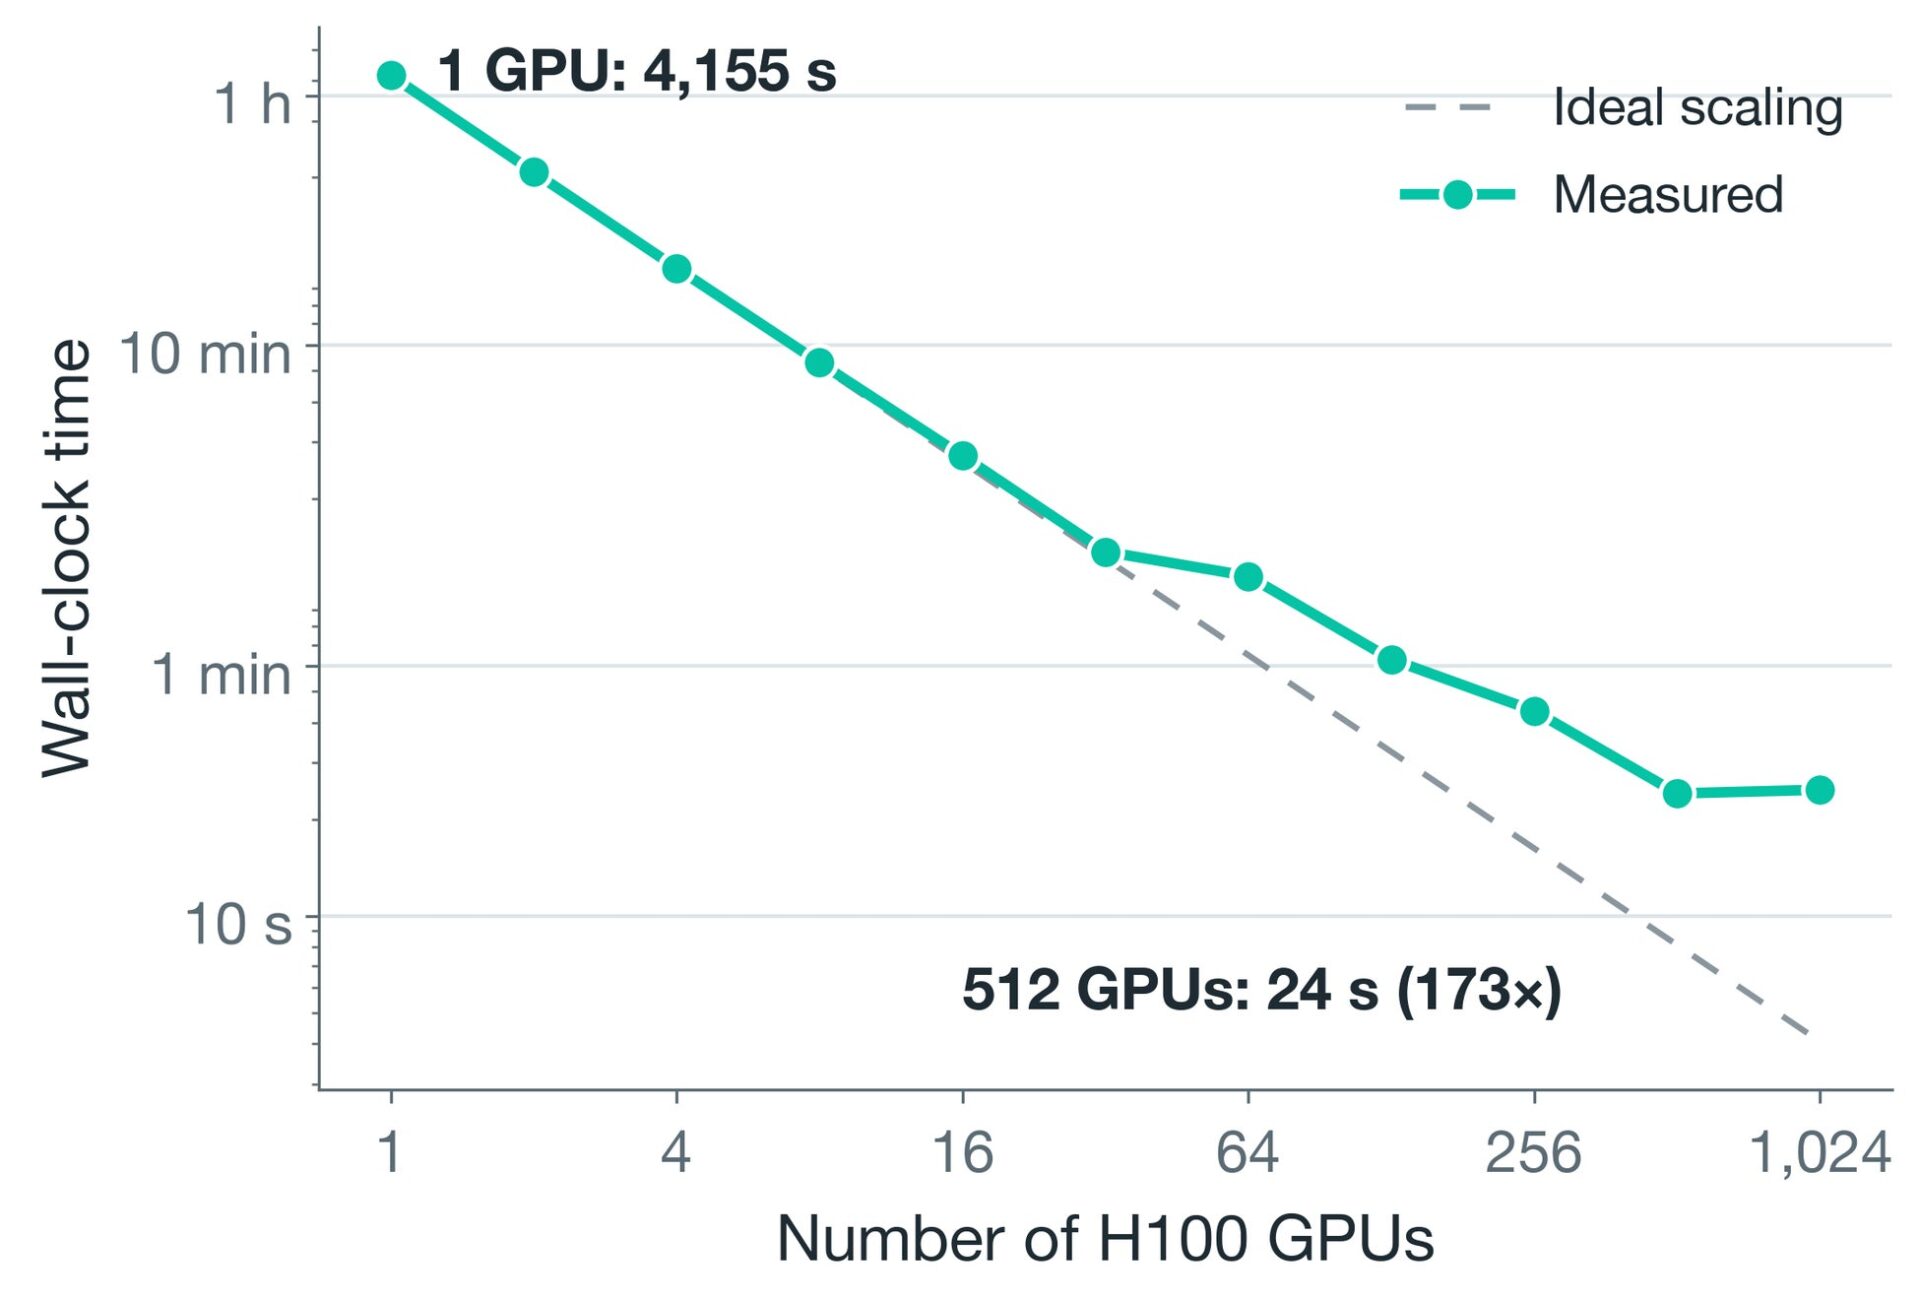
ただし、この回路規模ではGPU数の増加に伴って通信回数が増大し、通信のオーバーヘッドが顕在化するため、512基を超えた構成では高速化が頭打ちとなったことも報告されています。
Mr.ガジェット512基までは約173倍の高速化を記録したものの、それを超えるとGPU間の通信回数が増加して処理性能が頭打ちになる現象が実測で示されています。
Ms.ガジェット単に基数を増やせば無制限に速くなるわけではなく、通信負担による限界が実測値として明記されているのは客観的で参考になります。
各検証条件と測定結果の比較
今回のシミュレーションで実施された各評価条件の主要数値を以下にまとめます。
| 検証項目 | 対象分子モデル | 量子ビット数 | ゲート数 | 使用GPU数 | 主な検証結果 |
|---|---|---|---|---|---|
| 化学精度の確認 | 水素4原子(H4) | 28量子ビット(初期見積もり99) | 約3.19億ゲート(初期見積もり約17.8億) | 1,024基 | 約1.5時間で約100万回測定、厳密解との差0.53 mHa(化学精度達成) |
| 規模拡大(ビット数拡張) | 水素10原子(H10) | 42量子ビット | 約49万ゲート | 産総研ABCI-Qリソース | 誤差緩和条件下で最大42量子ビットのQPE回路を実行 |
| 強スケーリング評価 | 水素2原子(H2) | 32量子ビット | 固定QPE回路 | 1基〜1,024基 | 1基(約4,155秒)から512基(約24秒)で約173倍高速化、512基超で頭打ち |
Ms.ガジェットH4、H10、H2それぞれの計算目的と達成された数値が一覧表で整理されていて比較しやすいです。
国際会議「SC26」での発表と今後の研究開発
本研究の成果は、高性能計算分野の国際会議「SC26」のResearch Posters部門に採択されています。同会議は2026年11月15日から20日まで米国シカゴで開催され、「Chemically Accurate End-to-End Classical Simulation of Qubitization-Based Quantum Phase Estimation on 1,024 GPUs」の題目で発表が予定されています。また、2026年10月27日開催の同社主催カンファレンス「Xtangle 2026」においても報告が行われます。
QunaSysは今後、古典シミュレーションで扱える分子や回路規模をさらに広げるため、計算モデルの効率的表現や限られたリソースでの実行技術の高度化を進め、将来のFTQC実機に向けたアルゴリズムの信頼性向上に取り組む方針を示しています。
Ms.ガジェットSC26のResearch Posters部門への採択や自社カンファレンスでの報告など、学術と産業の両面での今後の進展に注目したいです。
- 本記事で使用している画像は、メディアユーザーとしてPR TIMESより提供されたプレスリリース素材を利用しています。
化学精度を求める多ゲート計算と、42量子ビットまで広げた多ビット計算の両面で限界性能を確かめている構成が分かりやすいです。